Teil 3 von 6
Vom Blatt Papier zum durchsuchbaren Archiv
Ein Stapel Briefe, ein Aufkleber und ein Knopfdruck. Wie aus Papier ein Archiv wird, das sich selbst sortiert, und warum ich das Original trotzdem in Sekunden finde.


Du kennst den Stapel vermutlich. Bei manchen liegt er auf dem Schreibtisch, bei anderen in einer Schublade oder in einem Karton mit der Aufschrift „Ablage“. Darin Briefe von der Versicherung, die Nebenkostenabrechnung, ein Bescheid vom Amt, irgendwo die Rechnung für die Waschmaschine. Und genau das Blatt, das man gerade braucht, liegt natürlich ganz unten.
Eine Rechnung wie die für die Waschmaschine, die ich in Teil 2 im Baumarkt aufs Handy hole, landet bei mir gar nicht erst auf so einem Stapel. Sie kommt als Brief, bekommt einen Aufkleber, ich drücke eine Taste, und danach muss ich nichts mehr tun. Am Ende hat das Dokument einen Titel, einen Absender und Schlagworte, und das Papier steckt in einem Ordner, aus dem ich es in Sekunden ziehe.
Kurz zur Orientierung: Teil 1 hat mein Homelab als Haus gezeigt, in dem jeder Dienst seine eigene Wohnung hat, eine virtuelle Maschine, kurz VM. Teil 2 war der Weg hinein. Jetzt schauen wir zum ersten Mal in eine einzelne Wohnung. Darin wohnt Paperless-ngx, ein Programm, das eingescannte Dokumente archiviert und durchsuchbar macht. Seine VM heißt paperless-01.
Bevor wir dem Brief Schritt für Schritt folgen, einmal der ganze Weg. Die linke Spalte spielt an meinem Schreibtisch, mit Aufkleber, Scanner, einem kleinen Computer daneben und dem Ordner fürs Papier. Die rechte Spalte läuft im Homelab ohne mich ab, von einem Netzwerkordner über Paperless bis zu einer Nachricht aufs Handy. Die Namen in den Kästen erkläre ich unterwegs.
Wir fangen bei Schritt 1 an, beim Papier.
Eine Nummer auf jedem Brief
Ein digitales Archiv beantwortet die Frage, was in einem Brief steht. Manchmal brauche ich aber das Original, etwa für eine Behörde oder eben für die Garantie. Dafür gibt es die ASN, die Archive Serial Number. Das ist eine fortlaufende Nummer, die auf dem Papier klebt und in Paperless am Dokument steht.
Abgelegt wird das Papier nur nach dieser Nummer, nicht nach Thema. Neue Briefe kommen einfach hinten in den Ordner, beim Abheften muss ich also nichts entscheiden. Brauche ich ein Original, suche ich es in Paperless, lese die ASN ab und blättere im Ordner zu genau dieser Nummer. Die Sortierung nach Absender, Jahr und Thema übernimmt das Archiv. Der Ordner muss nur zählen können.
Zurzeit liegen 768 Dokumente in Paperless, 666 davon tragen eine ASN, die höchste ist 971. Lücken stören nicht. Der Ordner bleibt aufsteigend sortiert, und eine fehlende Nummer überblättere ich einfach.
Die Aufkleber
Irgendwie muss die Nummer aufs Papier, und zwar so, dass ein Mensch sie lesen kann und eine Maschine auch. Die Etiketten erzeugt mein kleines Open-Source-Werkzeug ASN Label Maker. Es baut ein druckfertiges PDF mit einem Etikett pro Seite, 30 × 15 mm groß. Links sitzt ein QR-Code, eines dieser quadratischen Muster, die jede Handykamera lesen kann, mit dem Inhalt ASN00001. Rechts stehen „ASN“ und die fünfstellige Nummer zum Ablesen.
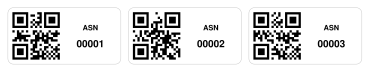
Warum ein QR-Code und kein Strichcode? Ein QR-Code bleibt auch auf 15 mm Höhe lesbar und wird in jeder Lage erkannt, auch wenn der Aufkleber schief klebt. Ein Commit mit dem schönen Namen „improve QR code recognition for Paperless“ hat außerdem den weißen Rand im Bild entfernt. Seitdem füllt der Code fast die ganze Etikettenhöhe aus, und Paperless liest ihn zuverlässiger.
Ein zweiter Kniff betrifft die Rolle. Beim Rollendruck liegt das zuletzt gedruckte Etikett außen, beim Abrollen wäre also die höchste Nummer zuerst dran. Mit --reverse druckt das Skript rückwärts, und die Rolle beginnt bei 00001:
uv run python asn_labels.py 1 100 --reverse -o asn_labels.pdf
Wer nichts installieren will, startet das Skript über ein Colab-Notebook, also direkt im Browser, und lädt das PDF herunter.
Ein Knopf am Scanner
Aufkleber drauf, Brief in den Einzug. Der Scanner ist ein Fujitsu fi-6130Z, und neben ihm steht ein Raspberry Pi, ein kleiner Computer im Scheckkartenformat. Auf dem Pi läuft docscanner, ein kleines Python-Programm von mir, das im Hintergrund wartet, bis etwas passiert. So ein Programm nennt man Daemon. Jede Sekunde fragt es über SANE, die Scanner-Schnittstelle von Linux, ob jemand die Scan-Taste gedrückt hat.
Das fertige Werkzeug scanbd hätte das auch gekonnt, braucht aber mehrere zusammenspielende Programme. So steckt alles in einem einzigen Python-Projekt, das sich mit einem Befehl (uv sync) neu aufsetzen lässt.
Drücke ich die Taste, scannt der Pi alle Seiten im Einzug beidseitig mit 600 dpi, als ein Bild pro Seite. Während der Scanner noch läuft, wird jede fertige Seite parallel aufbereitet. Sie wird gerade gerückt, im Kontrast angepasst, und fast weißes Papiergrau wird reines Weiß. Danach fügt das Werkzeug img2pdf die Seiten zu einem PDF namens Scan_<Datum>_<Uhrzeit>.pdf zusammen.
Der Eingangsordner
Das PDF muss jetzt vom Pi zu Paperless. Dazwischen liegt ein Eingangsordner, ein Netzwerkordner, den mehrere Rechner gleichzeitig benutzen können wie einen gemeinsamen Briefkasten. Er liegt auf meiner Dateiablage TrueNAS, also einem NAS, einem Rechner, der vor allem Speicherplatz im Heimnetz bereitstellt. Der Pi und paperless-01 hängen den Ordner beide bei sich ein, über NFS, die übliche Sprache für Netzwerkordner unter Linux.
Ganz direkt geht der Scan aber nicht in den Briefkasten. Er landet zuerst in einer Warteschlange auf dem Pi, und erst dann verschiebt ihn docscanner in den Eingangsordner. Ist der Netzwerkordner gerade nicht da, bleibt die Datei liegen, und docscanner versucht es alle fünf Minuten wieder. Ein Scan geht also nicht verloren, nur weil das NAS neu startet.
Eingehängt ist der Ordner außerdem „soft“. Mit der Voreinstellung „hard“ wartet ein Rechner im Zweifel endlos auf einen verschwundenen Netzwerkordner. Genau das hatte den Pi einmal so blockiert, dass zwar die Anmeldung per Fernzugang klappte, aber kein Befehl mehr zurückkam. Jetzt gibt es bei einem Ausfall einen Fehler statt eines eingefrorenen Systems.
Auf der anderen Seite schaut Paperless in den Briefkasten. Normalerweise erfährt es von neuen Dateien über eine Benachrichtigung des Linux-Kernels namens inotify. Über NFS kommt die aber nicht zuverlässig an, deshalb sieht Paperless alle 15 Sekunden selbst nach. Halb geschriebene Dateien mit Endungen wie .part oder .tmp lässt es liegen. Alles andere nimmt es mit und löscht es aus dem Eingang, Paperless nennt das „consume“.
Wer Teil 2 gelesen hat, kennt diese Stelle schon. TrueNAS ist noch kein Teil des verschlüsselten NetBird-Netzes, und der Weg vom Pi über das NAS zu Paperless läuft deshalb unverschlüsselt durchs Heimnetz. TrueNAS ins NetBird-Netz zu holen ist der nächste Schritt.
In Paperless
Jetzt ist der Scan in Paperless, und hier passieren vier Dinge nacheinander. Zwei Begriffe vorweg. OCR heißt Texterkennung, also das Umwandeln eines Bildes von Text in echten, durchsuchbaren Text; Paperless nutzt dafür das Programm Tesseract. Und ein Webhook ist eine Art Türklingel zwischen Programmen. Passiert etwas, klingelt das eine Programm beim anderen und sagt kurz Bescheid.
| Schritt in Paperless | Was passiert |
|---|---|
| Barcode | Findet einen QR-Code mit ASN… und setzt die Nummer als ASN am Dokument |
| OCR | Tesseract erkennt den Text, Seiten werden gerade gedreht, Ergebnis ist ein PDF/A, also ein PDF fürs Archiv, mit Textebene |
| Ablage | Datei wird nach Korrespondent, Jahr und Titel abgelegt |
| Workflow | „Dokument hinzugefügt“ klingelt per Webhook bei n8n und übergibt die Dokument-ID |
Die Klingel im letzten Schritt geht an den nächsten Mitbewohner im Haus.
Wer liest den Brief?
Der Text ist erkannt, aber das Dokument heißt noch Scan_20261015_145321 und trägt nur das Schlagwort „Eingang“. Den Rest erledigt n8n, ein Werkzeug für Automatisierungen, in dem man Abläufe aus Bausteinen zusammensteckt, ähnlich wie Kurzbefehle auf dem Handy. Es wohnt in der VM n8n-01. Ein solcher Ablauf heißt Workflow, und fünf davon bilden bei mir die Kette „Paperless 00–04“.
Gelesen wird der Brief dabei von einem Sprachmodell. Das ist ein Programm, das aus sehr viel Text gelernt hat, Texte zu verstehen und zu schreiben, wie bei ChatGPT. Meines ist Qwen3-30B-A3B. Es läuft mit dem Programm llama.cpp auf der eingebauten Grafik meines Arbeitsplatzrechners und nicht in der Cloud, der Brief verlässt das Haus also nicht. Die Workflows protokollieren außerdem nur Kennzahlen wie Dokument-ID und Zeichenzahl, nie den Inhalt.
Das Bild zeigt die Kette. Oben klingelt Paperless, in der Mitte ruft Workflow 00 die anderen vier nacheinander auf, und unten stehen das Sprachmodell und die Nachricht am Schluss.
Die Antworten des Modells kommen als JSON, ein Textformat, das wie ein ausgefülltes Formular mit festen Feldern aufgebaut ist. Was die vier Workflows tun, steht in der Tabelle. Der Korrespondent ist in Paperless der Absender.
| Workflow | Was er tut | Wer entscheidet |
|---|---|---|
| 01 OCR nach JSON | Zieht aus dem erkannten Text Absender, Empfänger, Datum, Betreff, Beträge, Aktenzeichen und eine Zusammenfassung; speichert alles als JSON in einem Zusatzfeld | Sprachmodell |
| 02 Korrespondent | Ordnet den Absender einem bekannten Korrespondenten zu, sonst „Unbekannt“ | erst feste Regeln, dann das Modell |
| 03 Tags | Setzt die Person aus dem Empfänger und ein bis vier Themen-Schlagworte | Person per Regel, Themen per Modell |
| 04 Abschluss | Titel aus dem Betreff, Datum, wenn es plausibel ist; „Eingang“ raus, „ai-processed“ rein | nur Regeln |
Das Modell darf nur wählen
Einem Sprachmodell die Ablage einfach so zu überlassen, wäre mir zu heikel gewesen. Die wichtigste Regel der Kette ist deshalb schlicht. Wo es eine Liste gibt, darf das Modell nur aus der Liste wählen. llama.cpp kann seine Antwort an ein JSON-Schema binden, also an eine Formularvorlage, die festlegt, welche Felder und welche Werte erlaubt sind. Für die Schlagworte sieht das so aus (gekürzt):
{"tags": {"type": "array", "minItems": 1, "maxItems": 4,
          "items": {"enum": ["<Schlagwort 1>", "<Schlagwort 2>", "…", "Unsortiert"]}}}
Die Liste kommt bei jedem Lauf frisch aus Paperless. Damit kann das Modell keinen zweiten Korrespondenten mit leicht anderer Schreibweise anlegen und kein neues Schlagwort erfinden. Passt nichts, landet das Dokument bei „Unsortiert“ oder „Unbekannt“, und ich sehe es.
Wo eine einfache Regel reicht, fragt die Kette das Modell gar nicht erst. Häufige Absender erkennt Workflow 02 an festen Regeln oder am exakten Namen, und nur wenn das nicht eindeutig ist, entscheidet das Modell. Das ist schneller, und wo eine Regel greift, liegt sie nie daneben.
Am Ende schickt Workflow 00 eine einzige Nachricht aufs Handy, über ntfy, einen selbst betriebenen Dienst für Push-Nachrichten. Darin stehen Titel, Korrespondent, Dokumenttyp und ein Link. Früher kam die Nachricht direkt von Paperless bei „Dokument geändert“. Weil jeder Schritt der Kette das Dokument ändert, bekam ich vier Nachrichten pro Brief, die ersten noch ohne Absender.
Dass das Modell nur im Hintergrund arbeitet, war übrigens nicht von Anfang an so.
Aus der Praxis: Paperless hat eigene KI-Vorschläge, und die waren anfangs eingeschaltet. Jedes geöffnete Dokument schickte eine Anfrage an das Sprachmodell, die bei langen Briefen über zwei Minuten dauerte. llama.cpp hatte zwei Plätze für gleichzeitige Anfragen, und beide waren dauernd belegt. Der Browser brach wartende Anfragen ab und beim Weiterklicken auch das Speichern, mit der Meldung „Status 0“. Ich habe die eingebauten Vorschläge abgeschaltet. Seitdem arbeitet das Modell nur noch über n8n im Hintergrund, wo niemand auf es wartet.
Zwei Abnehmer, ein Eingang
Eine Sache am Eingangsordner habe ich erst nach dem Umzug verstanden, und zwar auf die unangenehme Art.
Aus der Praxis: Am 29. Oktober stieß ich darauf, dass auf meinem Arbeitsplatzrechner noch die alte Paperless-Installation von vor dem Umzug lief. Ihre Neustart-Regel startete sie nach jedem Hochfahren des Rechners wieder, die nächtliche Sicherung hielt sie nur kurz an, und sie hatte denselben Netzwerkordner als Eingang eingehängt wie
paperless-01. Wer zuerst nachschaut, nimmt die Datei mit. Am 17. Oktober hatte die alte Kopie einen Scan vom 15. abgeholt, der deshalb im neuen Archiv fehlte. Ich habe das Original aus der alten Installation geholt und in den Eingang vonpaperless-01gelegt, erst als versteckte Datei, dann umbenannt, damit Paperless keine halbe Datei erwischt. Die Kette hat ihn mit allen fünf Workflows verarbeitet, und die alten Kopien sind jetzt gestoppt und starten nicht mehr von selbst.
Das Bild zeigt das Wettrennen. Links legt docscanner den Scan in den Eingangsordner in der Mitte, rechts schauen beide Paperless-Installationen nach, und wer zuerst kommt, nimmt ihn mit.
Seitdem weiß ich, dass „nach dem Umzug abgeschaltet“ erst dann etwas heißt, wenn auch die Neustart-Regel aus ist.
Zurück im Baumarkt
Stehe ich also wieder an der Servicetheke, finde ich die Rechnung für die Waschmaschine über die Suche in Paperless, mit Titel und Absender, die ein Sprachmodell aus einer vorgegebenen Liste gewählt hat. Will der Händler doch das Original sehen, steht am Dokument die ASN. Zu Hause greife ich in den Ordner, blättere zu genau dieser Nummer und habe das Blatt in der Hand. Für den Stapel ist in diesem Ablauf kein Platz.
Wenn ich zusammenfasse, was den Ablauf trägt, sind es zwei einfache Ideen. Das Papier wird nach Nummer abgelegt, und das Archiv übernimmt das Sortieren. Und alles, was langsam ist, läuft im Hintergrund, von der Warteschlange auf dem Pi bis zur Kette in n8n, die sich am Ende mit genau einer Nachricht meldet.
paperless-01 ist dabei nur eine von vielen VMs, und keine davon habe ich von Hand zusammengeklickt. Wie wird aus einer Textdatei eine laufende VM mit fertigem Dienst? Das zeigt Teil 4.